Viele KI-Lösungen arbeiten heute mit Retrieval Augmented Generation. Eine Frage löst eine Suche aus, die gefundenen Dokumente werden als Kontext geladen, und das Modell antwortet. Cache-Augmented Generation (CAG) geht einen anderen Weg und wird als Kostenhebel gern übersehen.
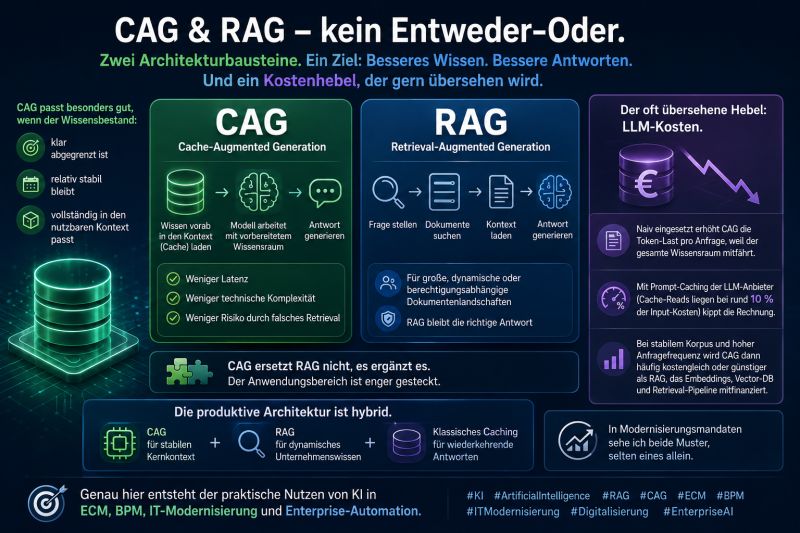
Bei CAG wird das relevante Wissen vorab in den Kontext oder Cache geladen. Das Modell arbeitet mit einem vorbereiteten Wissensraum und muss nicht bei jeder Anfrage suchen. Das senkt die Antwortzeit und vereinfacht die Technik. Fehler durch falsch gefundene Dokumente fallen weg.
CAG ergänzt RAG, mit engerem Anwendungsbereich. Es passt, wenn der Wissensbestand klar abgegrenzt und stabil ist und vollständig in den nutzbaren Kontext passt. Für große, sich laufend ändernde oder von Berechtigungen abhängige Dokumentenlandschaften bleibt RAG die richtige Wahl.
Die Kostenrechnung
Naiv eingesetzt erhöht CAG die Tokenlast, weil bei jeder Anfrage der gesamte Wissensraum mitgeschickt wird. Prompt-Caching dreht die Rechnung. Bei Anthropic etwa kosten Lesezugriffe auf den Cache rund ein Zehntel des normalen Eingabepreises. Bei stabilem Bestand und vielen Anfragen ist CAG dann oft gleich teuer oder günstiger als RAG, das Embeddings, Vektordatenbank und Retrieval-Pipeline mitfinanzieren muss.
Hybrid ist die Regel
In Modernisierungsprojekten sind mir beide Muster begegnet, selten eines allein. Die produktive Architektur verbindet CAG für den stabilen Kernkontext, RAG für das veränderliche Unternehmenswissen und klassisches Caching für wiederkehrende Antworten.